پایگاه داده چیست؟آشنایی با انواع دیتابیس
وقتی حجم و تعداد داده ها نسبت به قبل بیشتر می شوند باید مکانی را برای نگهداری داده ها در نظر بگیریم.اولین راه حلی که به نظر ما میرسد استفاده از دیتابیس است اما دیتابیس چیست؟از چه نوع دیتابیس برای نگهداری داده(Data) استفاده کنیم؟ این ها همه سوالاتی هستند که در این مقاله به آن پاسخ خواهیم داد پس تا پایان با ما همراه باشید.
پایگاه داده(دیتابیس) چیست؟
پایگاه داده(Database) ابزاری برای ذخیره،سازماندهی و مدیریت داده های در دسترس است. بدون وجود دیتابیس نمیتوان به انبوهی از اطلاعات دسترسی داشت.این موضوع نشان دهنده اهمیت دیتابیس است.برای دسترسی به این داده ها از یک سیستم مدیریت پایگاه داده(DBMS) استفاده می شود.
اجزای دیتابیس
وقتی از دیتابیس صحبت می شود یک توضیح کلی است و باید اجزای آن را به درستی توضیح داد:
داده(Data)
داده یا دیتا بنیان و اساس یک دیتابیس است.مجموعه ای از واقعیت های قابل ثبت در آن ثبت می شود مثل: جزئیات تماس یک فرد،صورتحساب خرید یک نفر،مشخصات محصولات و حتی داده های مکانی و داده های مولتی مدیا امکان ذخیره سازی آن در دیتابیس وجود دارد.
مدل داده(Data Model)
داده خام به تنهایی هیچ کمکی نخواهد کرد پس بنابراین باید ساختار کلی داده ها مشخص شود.مدل داده نشان می دهد داده ها چطور میتوانند با هم ارتباط داشته باشند،چگونه سازماندهی(Organize) شوند. مدل هایی مثل رابطه(Relational) و غیر رابطه ای(Non-Relational)، سندگرا(Document-Based)، گراف(Graph) نشان دهنده نحوه ذخیره سازی و ارتباطات و… هستند.
سیستم مدیریت پایگاه داده(DBMS)
این نرم افزار به ما کمک میکند تا بتوانیم به داده ها دسترسی و با آن ها تعامل داشته باشیم.DBMS کمک میکند تا بتوانیم دیتابیس را ایجاد،مدیریت،نگهداری و امنیت آن را تامین کنیم.همچنین DBMS وظایفی مثل مدیریت پرس و جو(Query)،مدیریت تراکنش ها(Transaction)،اعمال قواعد یکپارچگی داده ها و… را برعهده دارد. در واقع DBMS به دیتابیس روح و جان تازه ای می بخشد و دیتابیس بدون آن معنی ندارد
کاربران و برنامه های کاربردی
به نظر شما نهایت فایده وجود دیتابیس چیست؟قطعا پاسخ استفاده کاربران و برنامه های کاربردی(Application) ها است.از مدیر دیتابیس(DBA)، توسعه دهندگان نرم افزار،افرادی که در زمینه تحلیل دیتا(Data Analysis) فعالیت میکنند و در نهایت کاربران عادی و مردم که از نرم افزار استفاده میکنند همگی جزو دسته افرادی هستند که از دیتابیس ها استفاده میکنند.
اما DBMS چیست؟
همانطور که قبل هم اشاره کردیم برای مدیریت داده ها باید از یک ابزار به اسم DBMS یا Database Management System استفاده کنیم.
DBMS یک نرم افزار حرفه ای و یکپارچه است که به عنوان واسط بین کاربران و داده های ذخیره شده عمل میکند و دسترسی به داده ها را آسان میسازد.
اما بهتر است به جای جنبه های کلیشه ای آن به چند جنبه کلیدی و پر اهمیت دیگر بپردازیم:
| جنبه | توضیح |
|---|---|
| معماری | یکپارچه، کلاینت-سرور، توزیعشده، ابری (Cloud-native)، ریزسرویس، بدون سرور (Serverless) |
| مقیاسپذیری | عمودی (Scale-up) و افقی (Scale-out)، شاردینگ (Sharding)، پارتیشنبندی |
| همزمانی و تراکنش | ACID، BASE، کنترل همزمانی چندنسخهای (MVCC)، قفلگذاری، سطوح جداسازی، همزمانی خوشبینانه/بدبینانه |
| تحمل خطا و دسترسپذیری | تکرار (Replication) بهصورت master-slave و multi-master، جابهجایی خودکار (Failover)، الگوریتمهای اجماع (Raft/Paxos)، دسترسپذیری بالا |
| امنیت | احراز هویت، مجوزدهی (RBAC/ABAC)، رمزنگاری در حالت سکون و انتقال، حسابرسی، امنیت سطح سطر |
| بهینهسازی و ایندکسگذاری | ایندکس B-tree، هش، بیتمپ، ستونی، بهینهساز پرسوجو، برنامههای اجرایی |
| پردازش پرسوجو | SQL، بازنویسی پرسوجو، الگوریتمهای اتصال، اجرای موازی، اجرای برداریشده |
| یکپارچگی داده | محدودیتها (کلید اصلی/خارجی، یکتایی، بررسی)، تریگرها، یکپارچگی ارجاعی |
| پشتیبانگیری و بازیابی | پشتیبان کامل/افزایشی، بازیابی به نقطه زمانی (PITR)، لاگ تراکنش (WAL)، اسنپشات |
| مدیریت چرخه عمر داده | ETL/ELT، مهاجرت داده، بایگانی، سیاستهای نگهداری، ذخیرهسازی لایهای |
| رصدپذیری و مدیریت | پایش، لاگگیری، معیارها، ردیابی، تنظیم خودکار، داشبوردهای عملکرد |
| استقرار و عملیات | درونسازمانی (On-premise)، IaaS/PaaS/DBaaS، کانتینریسازی، اپراتورهای Kubernetes، CI/CD |
| تعامل و API | SQL، APIهای REST/GraphQL، درایورها، ORM، رویههای ذخیرهشده، توابع تعریفشده توسط کاربر (UDF) |
| تحلیل و پردازش ترکیبی | HTAP، همگرایی OLTP و OLAP، محاسبات درونحافظهای، ترکیب ستونی/سطری |
| حاکمیت داده | تبار داده (Data Lineage)، کاتالوگ، مدیریت فراداده، انطباق (GDPR، HIPAA) |
| هوش مصنوعی و اتوماسیون | بهینهسازی پرسوجو با کمک AI، پایگاهداده خودمختار، تشخیص ناهنجاری، خودترمیمی |
| چندمستأجری (Multi-tenancy) | طرح مشترک، طرح جداگانه، پایگاهداده جداگانه، سطوح جداسازی |
| پشتیبانی از انواع داده | JSON، XML، دادههای مکانی، سریهای زمانی، بردارهای تعبیهشده (Vector Embeddings)، BLOB/CLOB |
| کارایی و تأخیر | کشکردن، استخر اتصال، کپیهای خواندنی (Read Replicas)، محاسبات لبهای، طراحی کمتأخیر |
انواع پایگاه داده
پس از آن که با انواع پایگاه داده،اجزای تشکیل دهنده آن و جنبه های کلیدی پرداختیم زمان آن رسیده است که با انواع پایگاه داده آشنا شویم. دلیل وجود پایگاه داده های مختلف این است که ما میتوانیم در آن ها انواع مختلفی از داده ها را به شکل های مختلفی ذخیره کنیم.انتخاب نوع دیتابیس برای پروژه های نرم افزاری یک ضرورت بسیار مهم است که باید حتما قبل از شروع پروژه آن را در نظر گرفت.
دیتابیس های رابطه ای(Relational Database)
دیتابیس رابطه ای عضو قدیمی و یکی از پر کاربردترین دیتابیس ها است. در این نوع از دیتابیس ها جداول که از رکورد و ردیف تشکیل شده اند میتوانند با دیگر جداول ارتباط داشته باشند، هر جدول در این نوع دیتابیس نشان دهنده یک موجودیت مثل کاربر،محصول، و… است و از طریق کلیدهایی با نام(Foregin Key) با هم ارتباط برقرار میکنند.
برای کوئری نویسی در این گونه دیتابیس ها از زبان SQL یا Structured Query Language استفاده می شود.پایگاه داده رابطه ای بهترین و مطمئن ترین انتخاب برای زمانی است که یکپارچگی و قابل اطمینان بودن حرف اول را می زند.چرا که از اصول ACID یا Atomcity,Consistency,Isolation,Durablity پیروی میکند.
| مدل داده | جدولی (رابطهای) با ساختار از پیش تعریفشده (Schema-on-write) |
| زبان اصلی | SQL (زبان پرسوجوی ساختاریافته) |
| یکپارچگی داده | بسیار بالا، با تأکید بر اصول ACID |
| انعطافپذیری ساختار | کم (تغییر ساختار پس از طراحی پیچیده است) |
| مقیاسپذیری | عمدتاً عمودی (افزایش منابع یک سرور) |
| مزایای کلیدی | دقت و صحت بالا، یکپارچگی داده، قابلیت اطمینان، مناسب برای دادههای ساختاریافته |
| معایب اصلی | انعطافپذیری کمتر، چالش در مقیاسپذیری افقی برای دادههای بسیار حجیم |
| نمونههای معروف | MySQL، PostgreSQL، Oracle Database، Microsoft SQL Server، SQLite |
دیتابیس غیر رابطه ای(No-SQL)
محدودیت های دیتابیس رابطه ای باعث شد تا شکل دیگری از دیتابیس ها متولد شود که به معنای واقعی کلمه یک انقلاب بزرگ در زمینه مدیریت داده ها به وجود آمد. در دیتابیس های غیر رابطه ای عملا هیچ نام و نشانی از جدول ها نمی بینید و به شکل های مختلفی داده ها میتوانند با هم در ارتباط باشند. ویژگی دیتابیس غیر رابطه ای را در جدول زیر مشاهده میکنید:
| مدل داده | غیرجدولی و متنوع: سندی، کلید-مقدار، ستونی (Column-family)، گراف، چندمدلی |
| زبان اصلی | APIهای اختصاصی، JSON/BSON، Cypher (برای گراف)، زبانهای پرسوجوی خاص هر محصول؛ SQL در برخی نسخهها بهصورت محدود |
| یکپارچگی داده | غالباً مبتنی بر BASE (دسترسپذیری و تحمل خطا مقدم بر سازگاری لحظهای)؛ سازگاری نهایی (Eventual Consistency) |
| انعطافپذیری ساختار | بسیار بالا (Schema-less یا Schema-on-read)؛ تغییر ساختار آسان و بدون نیاز به مهاجرت گسترده |
| مقیاسپذیری | عمدتاً افقی (Scale-out) با شاردینگ و توزیع داده روی چند سرور |
| مزایای کلیدی | انعطافپذیری بالا، مقیاسپذیری افقی، عملکرد مناسب برای دادههای حجیم و نیمهساختاریافته، توسعه سریع |
| معایب اصلی | سازگاری و یکپارچگی ضعیفتر، نبود استاندارد واحد، پیچیدگی در پرسوجوهای پیچیده و تراکنشهای چندسندی |
| مدلهای اصلی | سندی (MongoDB، CouchDB)، کلید-مقدار (Redis، DynamoDB)، ستونی (Cassandra، HBase)، گراف (Neo4j، ArangoDB) |
| نمونههای معروف | MongoDB، Redis، Cassandra، HBase، Neo4j، CouchDB، DynamoDB، ArangoDB |
| کاربردهای مناسب | دادههای حجیم و جریانی، محتوا و کاتالوگ، کش و نشست، شبکههای اجتماعی و روابط پیچیده، اینترنت اشیا (IoT) |
به عنوان مثال هم اکنون نرم افزارهای مقیاس بزرگ مثل اینستاگرام از این نوع پایگاه داده(دیتابیس) استفاده میکنند.
پایگاه داده سندگرا (Document-Oriented Database)
پایگاه داده سندگرا یکی از مدلهای اصلی خانواده پایگاههای داده غیررابطهای (NoSQL) است که در آن دادهها به جای ذخیره در جداول با سطر و ستون، در قالب «اسناد» (Documents) نگهداری میشوند. هر سند معمولاً ساختاری شبیه به JSON، BSON یا XML دارد و میتواند مجموعهای از جفتهای کلید-مقدار، آرایهها و حتی اسناد تودرتو را در خود جای دهد. این ساختار، نگاشت طبیعیتری با اشیاء و ساختارهای داده در زبانهای برنامهنویسی مدرن ایجاد میکند و توسعهدهندگان را از پیچیدگی تبدیل مداوم داده بین مدل رابطهای و مدل شیءگرا رها میسازد.
یکی از بارزترین ویژگیهای این مدل، انعطافپذیری ساختاری است. برخلاف پایگاههای داده رابطهای که در آنها طرحواره (Schema) از پیش تعریف میشود و تغییر آن پس از طراحی معمولاً پرهزینه و پیچیده است، در پایگاه داده سندگرا هر سند میتواند ساختار داخلی منحصربهفرد خود را داشته باشد. به این ترتیب، دادههایی با ساختار تکاملیابنده یا ناهمگون را میتوان بدون نیاز به مهاجرت گسترده و بدون وقفه در سرویسدهی ذخیره و مدیریت کرد. این خصیصه بهویژه در پروژههایی که نیازمندیها بهسرعت تغییر میکنند یا دادهها از منابع گوناگون با شکلهای متفاوت وارد میشوند، ارزش بسیاری دارد.
در این مدل، دادههای مرتبط اغلب به دو صورت مدیریت میشوند: جاسازی (Embedding) که در آن دادههای وابسته بهصورت تودرتو درون یک سند قرار میگیرند و خواندن کل موجودیت را در یک عملیات ممکن میسازد، و ارجاع (Reference) که در آن اسناد با شناسه به یکدیگر اشاره میکنند و از افزونگی داده جلوگیری میشود. انتخاب بین این دو راهبرد، به الگوی دسترسی و نیازهای سازگاری بستگی دارد.
از منظر سازگاری و تراکنش، بسیاری از پایگاههای داده سندگرا بر سازگاری نهایی (Eventual Consistency) و مدل BASE تأکید دارند تا دسترسپذیری و مقیاسپذیری افقی را تضمین کنند؛ هرچند محصولات جدیدتر تراکنشهای چندسندی و ویژگیهای ACID را نیز در سطح محدود پشتیبانی میکنند. مقیاسپذیری افقی از طریق شاردینگ (توزیع اسناد روی چند سرور) و تکرار (Replication) از دیگر قابلیتهای کلیدی این پایگاههاست که آنها را برای حجمهای بالای داده و بارهای خواندنی سنگین مناسب میسازد.
پرسوجو در پایگاه داده سندگرا معمولاً از طریق APIهای اختصاصی مبتنی بر JSON انجام میشود (مانند زبان پرسوجوی MongoDB) و در برخی محصولات پشتیبانی محدودی از SQL نیز وجود دارد. این پایگاهها برای کاربردهایی نظیر مدیریت محتوا (CMS)، کاتالوگ محصولات، پروفایل کاربران، دادههای اینترنت اشیا و برنامههای موبایل و وب بسیار مناسباند؛ اما در پرسوجوهای تحلیلی پیچیده و تراکنشهای سنگین چندموجودیتی، نسبت به پایگاههای رابطهای محدودیت بیشتری دارند. نمونههای شناختهشده این دسته عبارتاند از MongoDB، CouchDB، Couchbase، RavenDB، Firestore و DocumentDB.
پایگاه داده کلید-مقدار (Key-Value Database)
پایگاه داده کلید-مقدار، سادهترین مدل در خانواده پایگاههای داده غیررابطهای (NoSQL) است. در این مدل، هر قطعه از داده بهصورت یک جفت «کلید-مقدار» (Key-Value) ذخیره و بازیابی میشود؛ به این معنا که هر مقدار داده با یک کلید یکتا شناسایی میشود و برای دسترسی به آن کافی است کلید مربوطه را در اختیار داشته باشیم. این ساختار را میتوان به یک لغتنامه یا جدول هش بسیار بزرگ و سریع تشبیه کرد که در آن کلید، نقش شناسه یکتا و مقدار، محتوای داده را ایفا میکند.
سادگی این مدل، مهمترین مزیت آن نیز به شمار میرود. از آنجا که عملیات اصلی تنها شامل جستوجو، درج، حذف و بهروزرسانی بر اساس کلید است، پایگاه داده کلید-مقدار سرعت فوقالعادهای در عملیات خواندن و نوشتن ارائه میدهد و بهویژه برای بارهای کاری با تأخیر پایین (Low-Latency) مناسب است. به همین دلیل، این پایگاهها اغلب در لایه کش (Cache)، مدیریت نشستهای کاربری، شمارندهها، صفهای پیام و ذخیرهسازی تنظیمات و پیکربندی به کار میروند.
از منظر مدل داده، برخلاف پایگاههای رابطهای، هیچ طرحواره (Schema) از پیش تعریفشدهای وجود ندارد و مقدار میتواند انواع مختلفی داشته باشد؛ از یک رشته ساده تا ساختارهای پیچیدهتر مانند JSON، لیست یا باینری. با این حال، پایگاه داده کلید-مقدار معمولاً نسبت به محتوای مقدار بیاطلاع است و پرسوجو بر اساس محتوای مقدار یا جستوجوهای شرطی پیچیده در آن بهسادگی امکانپذیر نیست؛ این محدودیت، مهمترین نقطه ضعف آن محسوب میشود.
از نظر مقیاسپذیری، این پایگاهها بهگونهای طراحی شدهاند که با مقیاسپذیری افقی (Scale-out) و توزیع دادهها بر اساس کلید روی چند سرور (شاردینگ) بهراحتی گسترش یابند. همچنین با استفاده از تکرار (Replication) و الگوریتمهای سازگاری نهایی (Eventual Consistency)، دسترسپذیری بالا و تحمل خطا را فراهم میکنند. در بسیاری از پیادهسازیها، دادهها در حافظه اصلی (In-Memory) نگهداری میشوند تا حداکثر سرعت دسترسی حاصل شود، هرچند امکان ذخیرهسازی پایدار روی دیسک نیز وجود دارد.
نمونههای شناختهشده این دسته عبارتاند از Redis، Amazon DynamoDB، Riak، Memcached (بهعنوان کش کلید-مقدار) و Berkeley DB. این پایگاهها در معماریهای مدرن، اغلب در کنار پایگاههای رابطهای یا سندگرا بهعنوان لایهای مکمل برای بهبود کارایی و کاهش بار سیستم اصلی به کار میروند.
پایگاه داده ستونی (Column-Family Database)
پایگاه داده ستونی یکی از مدلهای خانواده NoSQL است که در آن، برخلاف پایگاههای داده رابطهای که دادهها را بهصورت سطری ذخیره میکنند، دادهها بر اساس «خانواده ستونها» (Column Families) سازماندهی و ذخیره میشوند. در این ساختار، هر خانواده ستون مجموعهای از ستونهای مرتبط را در بر میگیرد و دادههای یک ستون بهصورت پیوسته در کنار یکدیگر روی دیسک قرار میگیرند. این نحوه چیدمان، برخلاف ذخیرهسازی سطری که تمام فیلدهای یک رکورد را پشت سر هم نگه میدارد، امکان خواندن کارآمد تنها بخشی از ستونها را فراهم میسازد.
مهمترین مزیت این مدل زمانی آشکار میشود که پرسوجوها تنها بر روی زیرمجموعه کوچکی از ستونها در حجم عظیمی از سطرها عمل کنند. در چنین حالتی، پایگاه داده ستونی بهجای خواندن کل رکورد، فقط ستونهای موردنیاز را از دیسک میخواند و بدین ترتیب مصرف I/O و زمان پاسخ را بهطور چشمگیری کاهش میدهد. به همین دلیل، این پایگاهها در سیستمهای تحلیل دادههای حجیم، انبارهای داده (Data Warehouses) و بارهای کاری تحلیلی (OLAP) کاربرد گستردهای دارند.
از منظر مدل داده، هر خانواده ستون میتواند شامل تعداد نامحدودی ستون باشد و ساختار آن نسبت به مدل رابطهای انعطافپذیرتر است. دادهها معمولاً بر اساس کلید سطر (Row Key) توزیع میشوند و هر سطر میتواند مجموعه متفاوتی از ستونها داشته باشد. مقیاسپذیری افقی از طریق شاردینگ و توزیع داده روی خوشهای از سرورها، و دسترسپذیری بالا از طریق تکرار (Replication) تأمین میشود. از جمله نمونههای شناختهشده این دسته میتوان به Apache Cassandra، HBase، Google Bigtable و ScyllaDB اشاره کرد.
پایگاه داده گراف (Graph Database)
پایگاه داده گراف یکی دیگر از مدلهای NoSQL است که زمانی کاربرد پیدا میکند که روابط بین دادهها به اندازه خود دادهها (یا حتی بیشتر) اهمیت داشته باشد. در این مدل، دادهها بهصورت «گرهها» (Nodes) و روابط بین آنها بهصورت «یالها» (Edges) نمایش داده و ذخیره میشوند. هر گره میتواند ویژگیهایی (Properties) داشته باشد و هر یال نیز میتواند جهتدار، برچسبدار و دارای ویژگی باشد. این ساختار، نمایشی طبیعی و مستقیم از موجودیتها و ارتباطات میان آنها ارائه میدهد.
برخلاف پایگاههای رابطهای که برای پیمایش روابط پیچیده ناچار به انجام اتصالهای (Join) متعدد و پرهزینه هستند، پایگاه داده گراف روابط را بهصورت ذاتی و در سطح ذخیرهسازی نگهداری میکند. به همین دلیل، پیمایش روابط (Traversal) در این پایگاهها بسیار سریعتر و کارآمدتر انجام میشود و عملکرد آن با افزایش عمق و پیچیدگی روابط، افت چشمگیری پیدا نمیکند. این ویژگی، پایگاه داده گراف را برای تحلیل دادههای بهشدت متصل ایدهآل میسازد.
این مدل بهویژه در کاربردهایی نظیر تحلیل شبکههای اجتماعی، سیستمهای توصیهگر، کشف تقلب، مدیریت هویت و دسترسی، موتورهای جستوجوی معنایی و کشف الگوهای پیچیده در دادههای متصل بینظیر است. زبانهای پرسوجوی اختصاصی مانند Cypher (در Neo4j) و Gremlin امکان بیان پرسوجوهای پیچیده گرافی را بهصورت خوانا و کارآمد فراهم میکنند. از نمونههای شناختهشده این دسته میتوان به Neo4j، ArangoDB، Amazon Neptune و JanusGraph اشاره کرد.
پایگاه داده ابری (Cloud Database)
پایگاه داده ابری، بهخودیخود یک مدل داده مجزا (مانند رابطهای، سندگرا یا گراف) نیست، بلکه به نحوه ارائه و میزبانی پایگاههای داده اشاره دارد. در این مدل، پایگاه داده بر روی زیرساخت یک ارائهدهنده خدمات ابری اجرا و مدیریت میشود و کاربر از طریق شبکه به آن دسترسی پیدا میکند. به عبارت دیگر، یک پایگاه داده ابری میتواند هر یک از انواع پیشین باشد؛ تنها تفاوت در این است که خرید، نصب، پیکربندی، نگهداری و مقیاسپذیری آن تا حد زیادی بر عهده ارائهدهنده ابر است.
این مدل که اغلب تحت عنوان DBaaS (Database as a Service) ارائه میشود، به کاربران اجازه میدهد بدون درگیری با پیچیدگیهای زیرساختی، بهسرعت از یک پایگاه داده آماده به کار بهرهمند شوند. در این حالت، ارائهدهنده ابر مسئولیت مدیریت سختافزار، شبکه، بهروزرسانی نرمافزار، پشتیبانگیری و در بسیاری از موارد امنیت و پایش را بر عهده میگیرد و تیم توسعه میتواند تمرکز خود را بر روی توسعه برنامه بگذارد.
یکی از مهمترین ویژگیهای پایگاه داده ابری، مقیاسپذیری بالا و اغلب آنی است. منابع پردازشی و ذخیرهسازی میتوانند بر اساس نیاز و بهصورت پویا افزایش یا کاهش یابند، بدون نیاز به خرید و نصب سختافزار جدید. این خصیصه همراه با دسترسپذیری بالا از طریق توزیع جغرافیایی و افزونگی (Redundancy)، پایگاه داده ابری را برای برنامههایی با بار متغیر و نیاز به پایداری سرویس مناسب میسازد.
از منظر هزینه، مدل ابری معمولاً بر اساس میزان مصرف (Pay-as-you-go) یا اشتراک ارائه میشود و هزینههای سنگین اولیه (CapEx) را به هزینههای عملیاتی (OpEx) تبدیل میکند. این ویژگی برای کسبوکارهایی که نمیخواهند در ابتدا سرمایهگذاری زیادی روی زیرساخت انجام دهند، جذابیت زیادی دارد. در کنار این مزایا، ملاحظاتی نیز وجود دارد؛ از جمله وابستگی به ارائهدهنده (Vendor Lock-in)، نگرانیهای امنیتی و حریم خصوصی بسته به ارائهدهنده و قرارداد، و هزینههای ترافیک شبکه که باید در طراحی معماری بهدرستی سنجیده شوند.
از جمله نمونههای شناختهشده پایگاه داده ابری میتوان به Amazon RDS، Azure SQL Database، Google Cloud SQL، MongoDB Atlas و سرویسهای پایگاه داده مدیریتشده ارائهدهندگان داخلی مانند ابر آروان اشاره کرد.
انتخاب نوع پایگاه داده مناسب برای پروژه
انتخاب نوع پایگاه داده، پیش از هر چیز به ساختار دادهها و نیازهای پروژه بستگی دارد. در یک نگاه کلی، اگر پروژه نیازمند دادههای کاملاً ساختاریافته (مانند سیستمهای مالی یا فروشگاهی)، تراکنشهای قابل اعتماد و یکپارچگی بالای داده مبتنی بر ACID، و روابط پیچیده بین جداول باشد، پایگاه داده رابطهای (SQL) مانند MySQL یا PostgreSQL انتخاب مناسب است. در مقابل، اگر پروژه با حجم عظیمی از داده (Big Data)، نیاز به سرعت بالا در خواندن و نوشتن، و انعطافپذیری در ساختار دادهها (مانند پروفایل کاربران در شبکههای اجتماعی) روبهرو باشد، پایگاه داده غیررابطهای (NoSQL) مانند MongoDB یا Redis گزینه بهتری خواهد بود.
کاربرد پایگاه داده در زندگی روزمره
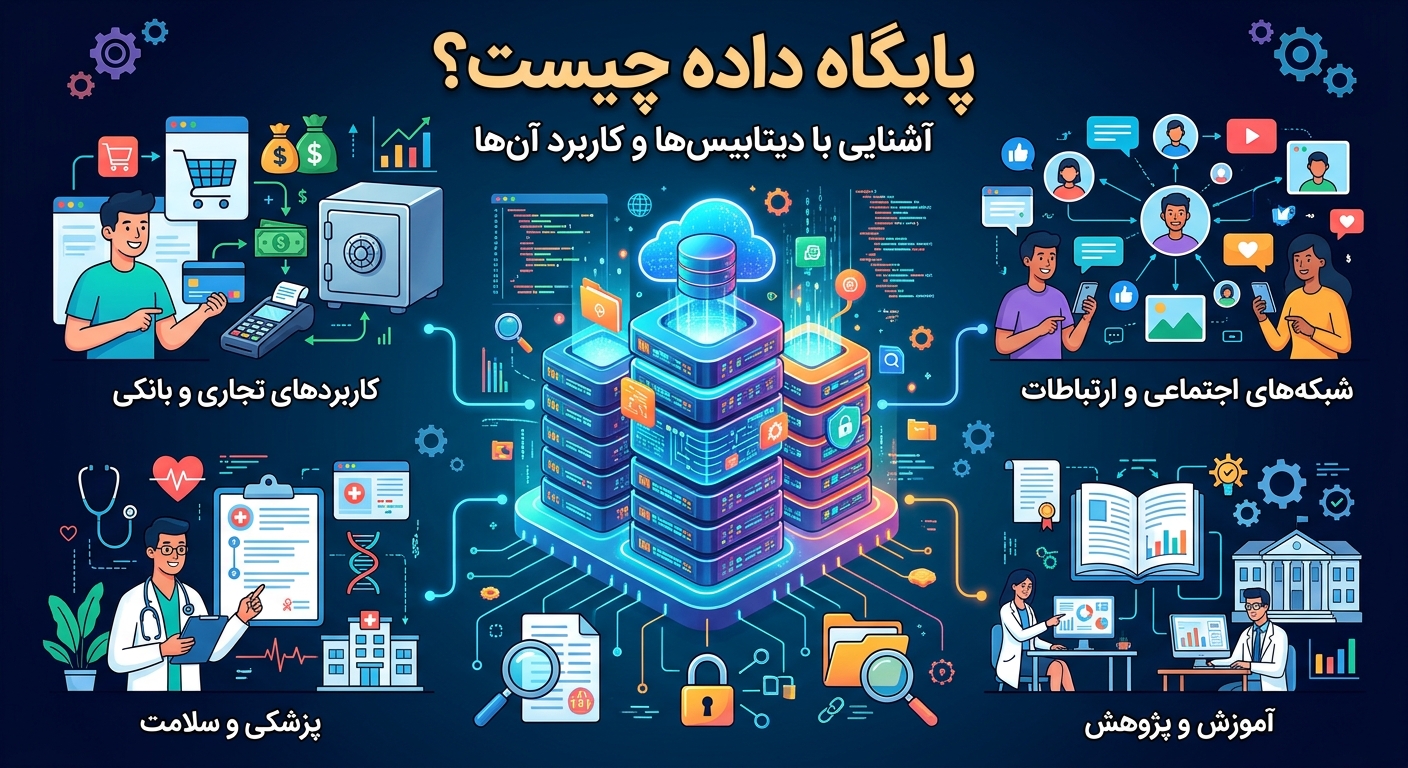
پایگاه داده تقریباً در هر گوشه از زندگی روزمره حضور دارد و وسعت این حضور نشان میدهد که اقتصاد جهانی بهشکلی جداییناپذیر به عملکرد صحیح این مخازن هوشمند داده وابسته است.
در تجارت الکترونیک، پایگاه داده مرکز فرماندهی عملیات است: ساماندهی کاتالوگ محصولات و پایش آنی موجودی انبار، ردیابی سفارشها از لحظه کلیک تا تحویل، نگهداری پروفایل مشتریان و تحلیل تاریخچه خرید، و قدرتبخشی به موتورهای توصیهگر برای ارائه پیشنهادهای شخصیسازیشده.
در بانکداری و امور مالی، جایی که هر تراکنش بار سنگینی از اعتماد و مسئولیت قانونی را به دوش میکشد، پایگاه داده نقشی بیبدیل در تضمین دقت، امنیت و شفافیت ایفا میکند: ثبت آنی و پردازش ایمن میلیونها تراکنش روزانه، مدیریت یکپارچه حسابها و سپردهها و وامها، شناسایی و مقابله با تقلبهای مالی، و تولید گزارشهای جامع برای تحلیل استراتژیک، مدیریت ریسک و رعایت مقررات نظارتی.
در شبکههای اجتماعی که به کلانشهرهای دیجیتال با جمعیت میلیاردی تبدیل شدهاند، پایگاه دادهها با قابلیتهای بالا در مقیاسپذیری، سرعت پاسخدهی و مدیریت روابط پیچیده، وظایفی چون نگهداری پروفایلها و نقشه ارتباطات اجتماعی، آرشیو و بازیابی تریلیونها واحد محتوا، ثبت و تحلیل تعاملات کاربران، و تغذیه الگوریتمهای هوشمند برای نمایش فیدهای شخصیسازیشده و پیشنهاد محتوای هدفمند را بر عهده دارند.
آینده پایگاههای داده
دنیای پایگاههای داده دائماً در حال تحول است تا پاسخگوی نیازهای روزافزون اپلیکیشنهای مدرن باشد. این تحول حول چند محور کلیدی شکل میگیرد:
۱. رشد پایگاههای داده تخصصی: دوران استفاده از یک نوع پایگاه داده برای تمام کارها به سر آمده است. آینده متعلق به پایگاههایی است که برای یک کار خاص بهینه شدهاند؛ مانند پایگاههای داده گراف برای تحلیل روابط، پایگاههای سری زمانی برای دادههای اینترنت اشیا، و پایگاههای جستجو برای جستجوی متنی.
۲. ادغام هوش مصنوعی و یادگیری ماشین: پایگاههای داده آینده بهصورت داخلی به قابلیتهای هوش مصنوعی مجهز خواهند شد؛ بهگونهای که خود پایگاه داده میتواند عملکرد خود را بهینه کند (Self-Tuning)، الگوهای داده را شناسایی کند و حتی پیشبینیهایی را مستقیماً از روی دادهها انجام دهد.
۳. معماری بدون سرور (Serverless): پایگاههای داده Serverless به توسعهدهندگان اجازه میدهند بدون نگرانی از مدیریت، پیکربندی و مقیاسدهی زیرساخت از پایگاه داده استفاده کنند و تنها بهازای میزان استفاده خود هزینه پرداخت کنند.
۴. معماری ابری: اکثر پایگاههای داده جدید با معماری ابری طراحی میشوند؛ یعنی ذاتاً برای اجرا در محیطهای توزیعشده، مقیاسپذیر و انعطافپذیر ابری ساخته شدهاند و از قابلیتهای این پلتفرمها به بهترین شکل بهره میبرند.
زیرساخت مناسب برای میزبانی پایگاه داده
انتخاب نوع مناسب پایگاه داده تنها بخشی از مسیر است؛ بخش مهمتر، انتخاب زیرساخت و میزبانی است که پایگاه داده روی آن اجرا میشود. عملکرد، پایداری و امنیت پایگاه داده مستقیماً به کیفیت سرور میزبان بستگی دارد. یک زیرساخت ایدهآل برای میزبانی پایگاههای داده حرفهای باید ویژگیهای کلیدی زیر را داشته باشد:
- حافظه ذخیرهسازی فوق سریع (NVMe SSD): پایگاههای داده بهطور مداوم در حال خواندن و نوشتن روی دیسک هستند و استفاده از NVMe بهجای هاردهای سنتی، سرعت اجرای کوئریها را بهطور چشمگیری افزایش میدهد.
- پایداری و دسترسپذیری بالا (High Availability): پایگاه داده از مهمترین اجزای اپلیکیشن است و نباید حتی برای یک لحظه از دسترس خارج شود؛ زیرساخت میزبان باید آپتایم تضمینشده نزدیک به ۱۰۰٪ ارائه دهد.
- قابلیت پشتیبانگیری آسان: تهیه نسخه پشتیبان منظم برای جلوگیری از فاجعه حیاتی است و پلتفرم میزبان باید ابزارهای ساده و خودکار برای این کار فراهم کند.
- مقیاسپذیری منابع: با رشد حجم دادهها و تعداد کاربران، باید بتوان بهسادگی منابع سرور (مانند CPU و RAM) را افزایش داد.
پایگاه داده ابزاری برای ذخیره، سازماندهی و مدیریت دادههاست و DBMS واسطی برای دسترسی، مدیریت و تأمین امنیت آن فراهم میکند. انتخاب نوع پایگاه داده به ساختار دادهها و نیازهای پروژه بستگی دارد: پایگاههای رابطهای برای دادههای ساختاریافته و تراکنشهای حساس با تأکید بر ACID مناسباند، و پایگاههای NoSQL (سندگرا، کلید-مقدار، ستونی و گراف) برای دادههای حجیم، نیمهساختاریافته و نیازمند انعطاف و مقیاسپذیری افقی. پایگاه داده ابری نیز مدلی برای ارائه و میزبانی است که مدیریت زیرساخت را ساده و مقیاسپذیری را پویا میکند. در نهایت، هیچ پایگاه دادهای برای همه کارها بهترین نیست و انتخاب درست، حاصل سنجش دقیق ساختار داده، نیازهای تراکنشی، الگوی دسترسی و ملاحظات هزینهای و امنیتی پروژه است.